BLOG
画像のトークンとは何か。固定パッチから、形に沿う領域表現まで
AIが画像を見るとき、一つのトークンには何が入るのでしょうか。正方形のパッチ、輪郭に沿う領域、一画素ごとの表現では、まとめる情報も計算の負担も変わります。精度の数字だけでは見えない違いを、画素からベクトルへ変わる過程から確かめます。

AIが画像を見るとき、何を一つの単位にするのか
家が写った写真を、AIに見せる場面を考えます。写真には空、屋根、窓、木があり、それぞれ形も細かさも違います。画像を理解するAIは、これらを最初から「空」「家」と読んでいるわけではありません。色などの数値を、計算しやすい特徴のまとまりへ変えて処理します。
Transformerは、入力した単位同士の関係を計算するAIの仕組みです。画像の特徴をこの仕組みへ渡す単位が、視覚トークンです。この記事では、Computer Vision(コンピュータービジョン)の画像認識を中心に、トークンが何を表し、作り方によって何が変わるのかを説明します。画像生成で使う離散的なコードや、チャットサービスの課金単位とは、区別して考えます。
Vision Transformerの原論文トークンは、小さな画像そのものではなく数値の列
カラー画像の1画素には、例えば赤・緑・青の三つの値があります。固定パッチ方式では、近くの画素を正方形にまとめます。16×16画素なら、三つの色を合わせて768個の値です。基本的なVision Transformer(ViT)は、それを学習する変換に通し、決まった長さの数値の列へ写します。この特徴の列をベクトル、または埋め込みと呼びます。

このベクトルには、認識に使える特徴が学習されます。「この1個が家という単語に相当する」とあらかじめ決まっているわけではありません。画像のどこに由来するかを伝える位置の情報も加え、Transformerの中で他のトークンとの関係を調べます。
224×224画素を16×16画素ずつに分けると、縦14個・横14個で196個の画像トークンになります。原論文の分類用ViTでは、画像全体を集約する特別なトークンを追加するため、系列は197個です。画像を分けた数と、モデルに入る系列全体の長さも、同じとは限りません。
原論文:パッチの埋め込みと位置情報固定パッチは、形よりも規則正しく計算することを優先する
固定パッチは画像のどこでも同じ大きさです。空だけが入るパッチもあれば、窓と壁の境界をまたぐパッチもあります。物体の輪郭に沿わなくても、一定の数と形のデータをまとめて計算できるため、実装や並列処理を組み立てやすい方式です。
パッチ化は、単純に画素の平均色へ置き換える処理ではありません。パッチ内の情報を学習した変換で特徴にします。ただし、一つの単位に異なる部分が混ざることや、特徴へ写すときに何を残すかは、後の認識に影響します。固定パッチだから細部を一切扱えない、と断定するのも正確ではありません。
ViTのようなモデルは、多数のパッチの関係から画像全体を理解します。一つのパッチが物体全体を表していなくても、複数の特徴を組み合わせて認識できるのです。
原論文:画像を系列として処理する設計細かく分けると、情報だけでなく比較する相手も増える
同じ224×224画素でも、パッチの一辺を16から8へ半分にすると、画像トークンは196個から784個へ4倍になります。さらに1画素ずつにすると50,176個です。細部を別々の単位で扱える一方、処理する系列が長くなります。
| 一単位の大きさ | 画像トークン数 | 相互参照の組数比 |
|---|---|---|
| 16×16 画素 | 196個 | 1倍 |
| 8×8 画素 | 784個 | 16倍 |
| 1×1 画素 | 50,176個 | 65,536倍 |
すべてのトークン同士の関係を調べる通常のSelf-Attentionでは、組み合わせの数はおおむねトークン数の二乗で増えます。4倍のトークンなら、その相互参照部分の計算は16倍に増える関係です。ただし、これをそのままモデル全体の処理時間や必要メモリの倍率にしてはいけません。
モデル内には別の計算もあり、実装によっては全組み合わせの表を一度に保存しません。FlashAttentionのような実装は、同じAttentionを計算しながらメモリの使い方を工夫しています。トークン数は重要ですが、それだけで実際の速さを決められるわけではありません。
FlashAttention-2:計算とメモリ使用の関係違いは、細かさ・形・階層の三つに分けて見る
固定パッチの代わりを考えるときは、三つの問いに分けると整理できます。場所ごとに細かさを変えるのか。正方形のままではなく境界に沿う形にするのか。細かい領域と大きな領域の関係を使うのか、という問いです。

適応的パッチは場所ごとに大きさを変え、領域トークンは画像の特徴に応じた形でまとめます。ピクセルトークンは、最初に近隣画素を一つに集約することを最小限にした方式です。階層的な方式は、細かい領域から大きな領域までの関係を利用します。
これらは、完全に排他的な五つの箱ではありません。例えば∂HTは、領域の形を画像に合わせながら、その領域の階層も使います。適応的な正方形パッチにも階層を持たせられます。形を変える研究と、階層を使う研究を、別々の競合方式だと決めつけないことが大切です。
どの方式も、最終的には特徴を表す数値のベクトルとして処理します。主に変わるのは、その一単位へどの情報をまとめるかです。
∂HT論文:既存方式の整理と階層的領域分割適応的パッチ。必要な場所へ細かさを配る
空のように広く似た特徴が続く場所は大きなパッチで、窓や小物がある場所は小さなパッチで扱えたら、認識に必要な細部を残しながら、トークンを減らせるかもしれません。ただし、見た目が複雑な場所と、課題に重要な場所は必ずしも同じではありません。
2026年11月3日に公開されたSPLITは、粗い特徴を手掛かりに、どこを細かく分割するかを学習する方式です。著者らは、分類の比較で約30%少ないトークンを使いながら、元のViTに近い精度を報告しています。物体検出や領域分割も評価しています。
重要なのは、トークンを減らす判断や、大小の特徴を作り、まとめて並べる処理にも費用があることです。論文は、その追加処理も含めた速度を調べています。また、目標とする削減率は学習時に決めており、別の削減率にするには短い再学習が必要です。推論の設定を一つ変えるだけで、好きな速さへ自由に切り替えられるという発表ではありません。別の課題へ分割の方策をそのまま使い回せるかも、論文では今後の検討としています。
SPLIT論文:分割方策・実測・限界領域トークン。境界に沿って特徴をまとめる
スーパーピクセルは、近くにあり、色や学習した特徴が似ている画素などをまとめた小領域です。固定パッチのように、輪郭と無関係な正方形で切る必要がありません。ただし、一つの領域が必ず一つの物体になるわけではなく、一つの物体が複数領域へ分かれる場合もあります。
2025年1月にTMLRへ掲載されたSPFormerは、細かな画素側の特徴と、領域側の特徴をCross-Attentionで関連付け、双方を繰り返し更新します。Cross-Attentionは、別々の特徴の集まりの間で、どの情報を参照するかを計算する仕組みです。前処理で境界を一度決め、あとは変えない構成とは異なります。
SPFormerも、最初の細かな特徴を作る段階では、4×4の固定的な小パッチを使います。固定パッチを一切使わないというより、その先で大きな単位をどうまとめ、更新するかを変える設計です。
写真の種類を答えるImageNet分類では、DeiT-Sの79.9%に対しSPFormer-Sは81.0%で、1.1ポイント高い結果です。学習で調整する値の数(パラメーター数)は、どちらも公表値で22M、約2,200万個ですが、演算量は4.6から5.2 GFLOPsへ増えています。「同じ規模の比較で高精度」と「同じ計算量で優位」は分けて読む必要があります。GFLOPsは演算量を表す単位で、実際の処理時間とは異なります。
ImageNetで先に特徴を学習したモデルを使う、評価データADE20Kの領域分割でも、42.3から46.5 mIoUへ改善しています。mIoUは、予測した領域と正解領域の重なりを評価する指標です。こちらは演算量32から35 GFLOPs、パラメーター数も表の値で22Mから23Mへ増えています。分割の形だけを差し替えた実験ではなく、特徴の生成・更新を含むモデル全体の比較です。
SPFormer最終掲載版:構成と評価表階層的な領域。どの大きさでまとめるかも選ぶ
家の画像には、窓の枠のような細部と、壁や屋根のような広い部分があります。∂HT(微分可能な階層的トークン化)は、隣り合う画素の特徴を使って領域をまとめ、細かい分割から粗い分割までの階層を作ります。その中から、情報のまとまりと複雑さの釣り合いを考えて分割を選びます。

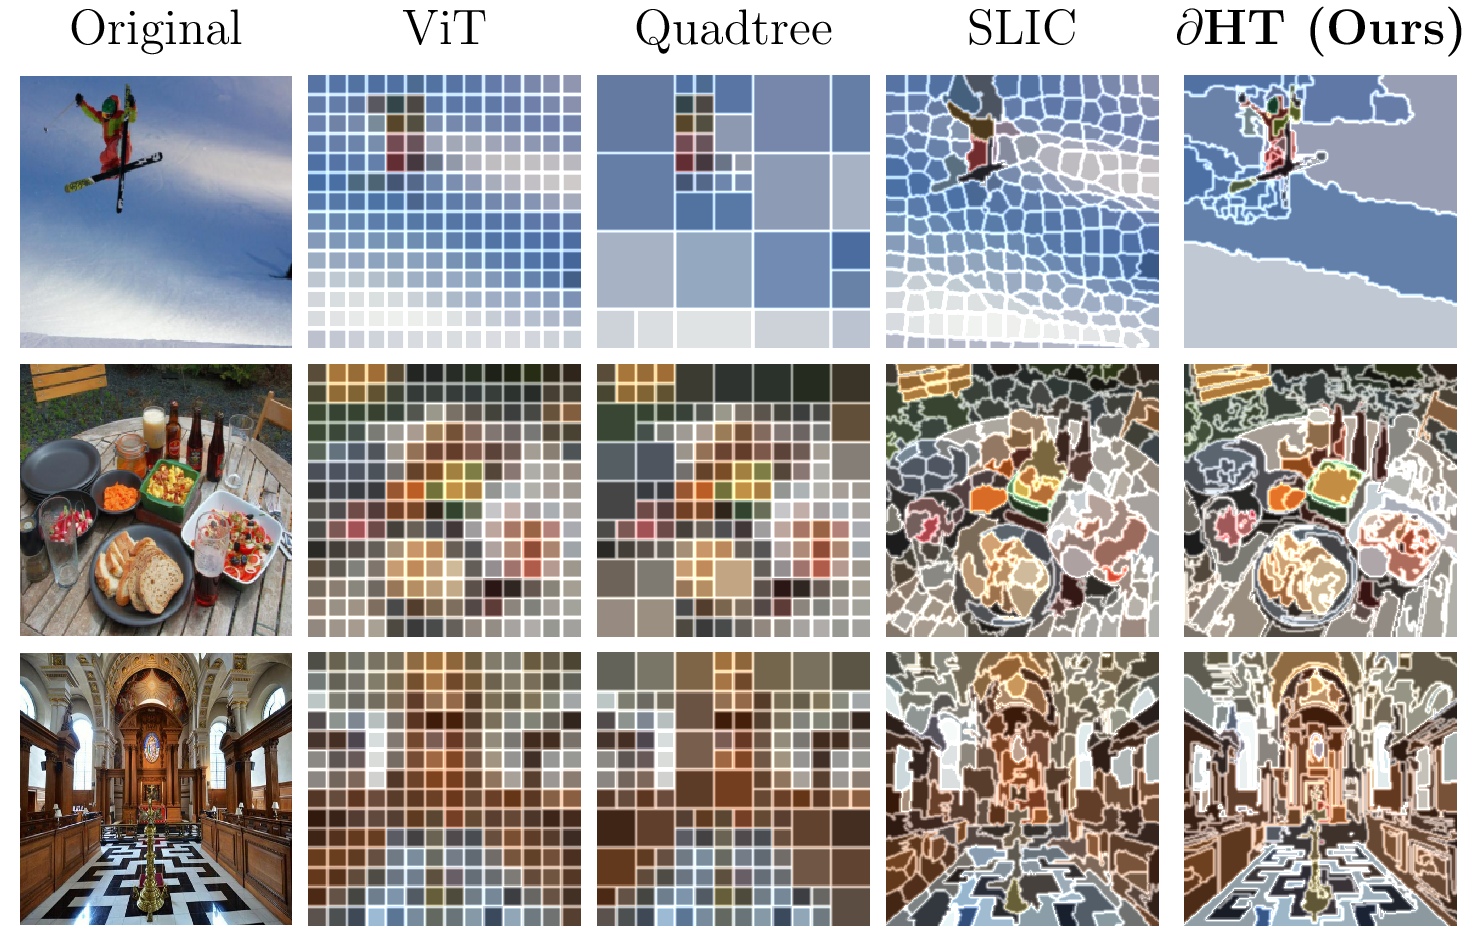
階層を作ることは、全段階の画像をそのまま全部Transformerへ積み重ねて送ることと同じではありません。選んだ分割に従って領域の特徴を取り出すところまでが、この方式の重要な部分です。また、認識の学習で生じる誤差を、領域の特徴を作る部分にも返せるように設計しています。
論文のImageNet-1Kで最初から学習するViT-B/16の比較では、固定パッチ81.9%に対し∂HTは83.2%でした。一方、効率の比較表の224×224・B16構成では、平均系列長は197から246へ増え、処理効率も下がっています。精度向上の例ではありますが、トークン数も速度も必ず改善する方式ではありません。
同じ論文の高解像度構成には、トークン数が減る条件もあります。入力やモデルによって結果が変わるため、一つの表の条件だけを方式全体の性質として一般化しないことが必要です。
∂HT論文:階層の選択と精度・効率の評価ピクセルトークン。集約しない方向から確かめる
2025年のICLR論文「An Image is Worth More Than 16×16 Patches」は、1画素を一つのトークンとして処理する比較を行いました。厳密には1×1パッチとも呼べるため、まったく別の数値形式というより、最初の集約を最小にした方向です。
ImageNetのViT-Lでは、2×2パッチの75.6%に対し、1画素単位で76.9%という結果です。ただし、この主比較の入力は28×28画素です。深度推定の改善例も48×64画素での評価です。一般的な高解像度のモデルにそのまま当てはめて、最高精度を更新したとは言えません。
著者らも、計算量の面で実用性に限界があると述べています。この研究から学べるのは、固定パッチが認識に不可欠な唯一の表現ではなく、情報を細かく扱うことと計算を軽くすることの折り合いでもある、という点です。
個々の画素を扱うTransformerの論文精度の数字は、論文ごとの比較の中で読む
次の表は、それぞれの論文の中で比較された結果を整理したものです。論文をまたいで学習データ、入力の解像度、モデルの大きさ、学習法が一致しているわけではないため、横断的な順位表にはできません。
| 論文内の比較 | 結果と、併せて読む条件 |
|---|---|
| SPFormer 画像分類 | DeiT-S 79.9% → SPFormer-S 81.0%。公表パラメーター数は双方22M。演算量は4.6 → 5.2 GFLOPs。入力224×224、196画像トークンの比較。 掲載版の表1 |
| SPFormer 領域分割 | ADE20Kで42.3 → 46.5 mIoU。双方ImageNet事前学習あり。演算量32 → 35 GFLOPs、パラメーター数22M → 23M。 掲載版の表3 |
| ∂HT 画像分類 | 固定パッチ81.9% → ∂HT 83.2%。ViT-B/16、224×224、ImageNet-1Kで最初から学習する条件。別途、トークン化の負荷で処理効率が低下すると報告。 表1と効率の表9 |
| 画素単位 画像分類 | 2×2パッチ75.6% → 1画素76.9%。ImageNetのViT-L、入力28×28という低解像度の比較。通常解像度の最高精度との比較ではない。 表3と学習条件 |
分類精度は、何の画像かを答える評価です。領域分割のmIoUは、どこからどこまでが対象かを評価します。深度推定の誤差は、距離の予測を評価します。単位と課題が違う数値を、同じ「認識能力」の一つの点数として扱わないことも重要です。
SPFormer掲載版の評価条件画像のトークンと、言語モデルへ渡るトークンは同じとは限らない
画像と言葉を扱うAIでは、画像認識側で作った特徴を、別の仕組みでまとめ直してから言語モデルへ渡す場合があります。例えばIdefics2は、画像の特徴をPerceiverという仕組みで一定数の特徴へ圧縮して接続します。
つまり、画像を最初に何パッチへ分けたか、視覚モデルが何個の特徴を処理したか、言語モデルが何個を受け取るかは、異なる数になり得ます。チャットサービスが表示する画像の使用量を、この記事の196個などの例へ直接置き換えることはできません。どの段階のトークンを数えているかが必要です。
Hugging Face:Idefics2の視覚特徴と言語モデルへの接続考察。どんな情報を残したいかで、適した単位は変わる
細い線や小さな文字が重要な課題では、入力で見えなくした情報を後の計算だけで完全に取り戻すことはできません。一方、広い領域の関係を知りたい場合は、全画素を同じ細かさで扱う費用が見合わない可能性があります。どこへ表現の細かさを配るかが、認識と効率の両方につながります。
ただし、2D画像をうまく領域に分けるだけで、3D形状や時間変化まで得られるわけではありません。複数の視点のどの部分が対応するか、奥行きやカメラの位置をどう求めるか、次の時刻のどの領域が同じ対象かといった、別の推定が必要です。物体を横切る境界が減ることと、物体の同一性を時間を超えて保持できることは、異なる達成条件です。
実用を考えるなら、まず必要な細部が残る解像度と課題を決めます。そのうえで、同じ条件の固定パッチを基準に、認識の品質、トークンを作る時間、全体の処理時間、メモリ、画像ごとのばらつきを比べます。研究の可能性を評価しながら、どこまで実証されたかを見失わないための読み方です。
∂HT論文:適応的表現の効果と限界