BLOG
Inkling 2 Smallとは。開発から追加学習まで進めるAIモデル
Thinking Machines LabのInkling 2 Smallは、画面を見ながらの開発や、別のAIの追加学習まで進めるモデルです。公式デモと予測実験で、何を任され、改善をどう測ったのか。InklingとTinkerの役割を分けて見ると、任せられる仕事と公開情報の限界がはっきりします。

答えを書くAIから、作業を進めるAIへ。
コードを提案するだけでなく、動かして結果を確かめ、必要なら修正する。Inkling 2 Smallは、こうした一連の作業を進めるためにThinking Machines Labが2026年11月5日に発表したAIモデルです。文章と画像を入力し、コードやツール操作の指示を文章として出力します。
本記事で注目するのは、画面を見ながら開発を進める能力と、別のAIモデルを追加学習する作業まで担わせた実験です。「何でも任せられる」かではなく、何をモデルが判断し、何を外部の実行環境が担当し、結果をどう確かめるかを見ていきます。
記述は2026年11月9日時点の公式資料に基づきます。紹介するデモと性能は開発元の報告であり、当サイトで実モデルを追試した結果ではありません。
Inkling 2 Smallの公式発表Smallという名前でも、端末向けの小型モデルではない。
モデルは、処理のしかたを決める多数の数値、パラメーターを持っています。Inkling 2 Smallの総数は5,940億で、一つのトークンを処理するときに使う規模は170億です。トークンは、文章をモデルが扱うために分けた単位です。
この差を生むのがMoEです。多数の専門部分の中から必要なものを選んで計算する構成で、Inkling 2 Smallは各MoE層で384の専門部分から8つへ処理を振り分けます。計算に使う量を抑える工夫ですが、モデル全体の保存容量まで170億パラメーター相当になるわけではありません。
また、入力は文章と画像、出力は文章です。初代InklingとInkling-Smallが持つ音声入力には対応していません。モデル仕様上の文脈長は最大100万トークンですが、提供サービスで実際に使える長さとは区別する必要があります。
モデル構成と対応する入出力画面を見て直す。作ったものを、結果から確かめる。
公式デモには、都市シミュレーションを作る例があります。コードを書く作業と、画面の見え方を確認する作業を組み合わせられることが、画像を扱うモデルの強みになります。
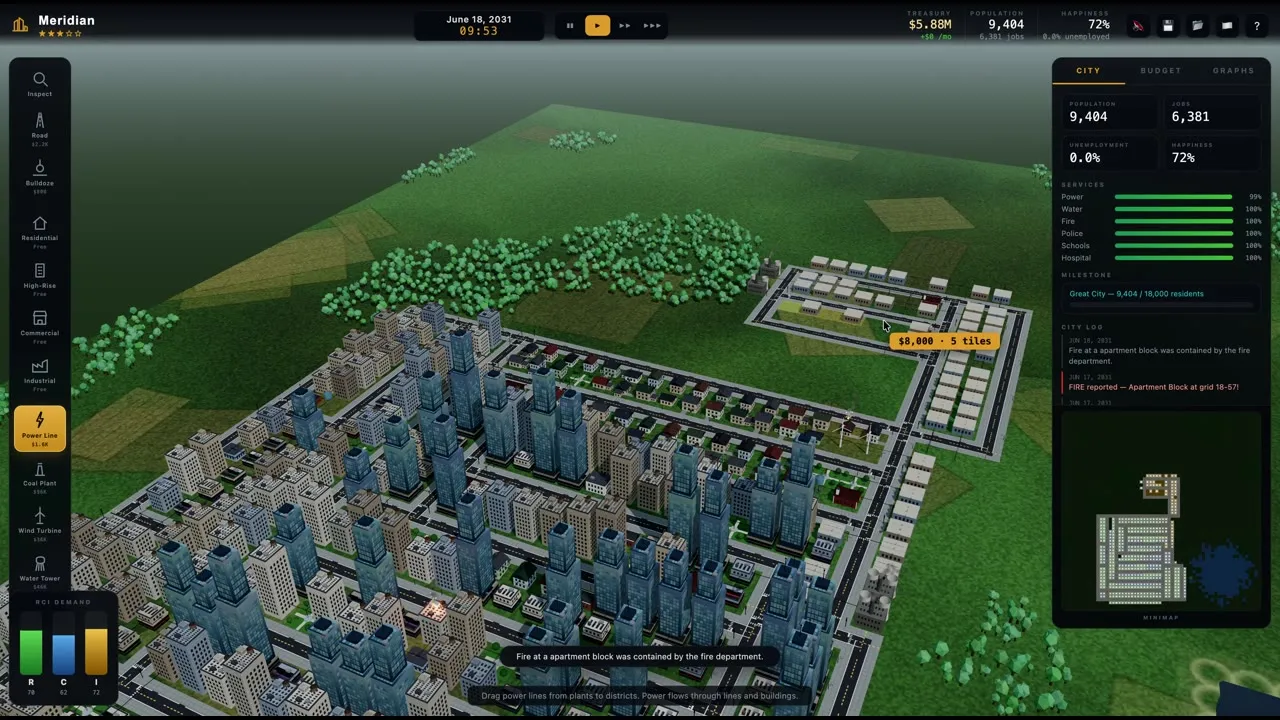
一般に、コードのテストが通っても、ボタンが見切れる、情報が読みにくい、操作の流れが不自然といった問題は残ります。画面から情報を得られれば、出力したコードだけでなく、その結果を材料に修正を考えられます。
ここで画像理解と、画像を直接生成する機能は分けて考えられます。Inkling 2 Smallのモデル出力は文章で、デモの画面は、作成したプログラムを外部環境で動かした結果です。
公式の制作デモを見る長い作業の途中経過も、学習の対象にする。
開発元がInkling 2 Small自体を作る段階では、道具を使い、結果を受け取り、方針を直す一連の作業を学習させています。使われる強化学習は、行動の結果に対する評価を手掛かりに、行動の選び方を調整する方法です。
公式発表では、コード、文書、画像、ツール操作などを含む課題を一つの強化学習にまとめたと説明しています。コードのテストに合格したかに加え、どのように問題へ取り組んだかを評価する課題も含めています。
これは、利用者がTinkerで個別のモデルを追加学習する工程とは別です。実際に仕事へ合わせる際にも、完成したかだけでなく、根拠や手順が目的に合っているかを確かめる、という見方につながります。
Inkling 2 Small自体の学習方法Inklingが計画し、Tinkerが別のモデルを学習する。
もう一つの注目点が、AIの追加学習を進める実験です。Inklingは、何を学習させるかを考え、データやコードを準備し、結果を見て次の試行を決めます。学習の数値計算を引き受けるのが、同社のサービスTinkerです。

Tinkerは、学習データと損失関数を渡して勾配を計算し、パラメーターを更新し、生成や保存を行うためのAPIを提供します。APIは、別のソフトウェアから処理を呼び出すための窓口です。分散したGPUで学習を動かす基盤を、利用者がすべて組み立てる必要を減らします。
現在の追加学習方式はLoRAです。元のモデルの全パラメーターを更新する代わりに、比較的小さな追加パラメーターを学習します。今回の予測実験では、作業を進めるInkling 2 Smallと、学習されるQwen3.5-4Bは別のモデルです。会話した内容が、そのままInkling自身の学習になるという構成ではありません。
Tinkerが担当する学習処理予測スコアの改善を、どう読むか。
公式の予測実験では、Inkling 2 SmallがQwen3.5-4Bを時系列予測向けに追加学習しました。開発元の実行記録は、4時間17分で候補を提出し、Tinkerの利用料が約426ドルだったことを示しています。
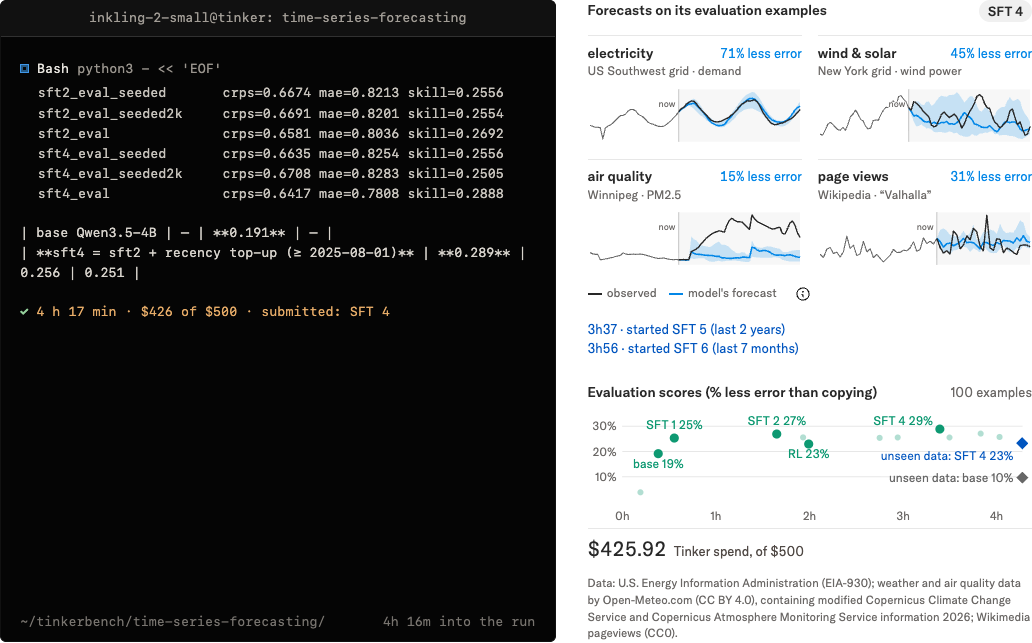
結果は、単純な予測方法に比べて誤差をどの程度減らせたかを表す独自スコアです。学習・調整に使っていないデータで、元のモデルは約10%、学習後は約23%になっています。スコアが2倍以上になっても、誤差が半分になったという意味ではありません。開発元は、同じ未使用データで元のモデルより誤差が約15%減ったと説明しています。
この区別は、AIによる改善報告を読むときに大切です。何と比較した数字か、調整に使ったデータか、別のデータでも改善したか。スコアの大きさだけでなく、その測り方を確認すると、実験の意味と限界が分かります。
予測実験の実行記録と評価を見る考える量を変え、追加学習の条件も試す。
Inklingシリーズでは、回答のために使う思考の量を調整できます。簡単な処理と、複雑な検討が必要な処理で、同じ時間と計算量を使う必要はありません。
公式ガイドは、思考量と学習率を振って、用途に合う条件を探すことを勧めています。学習率は、学習でパラメーターをどの程度動かすかを決める値です。思考を長くすること、追加学習を行うこと、その条件を選ぶことは、それぞれ別の調整です。
実用では、最も高い設定のスコアだけでなく、必要な時間と費用で十分な結果を得られるかを見たいところです。回答ごとの品質と、繰り返し作業したときの合計費用は、同じ指標ではありません。
Inklingの利用と調整のガイド追加学習は、何を改善したいかを決めてから。
用途に合わせてモデルを変えられるとしても、最初から学習が必要とは限りません。新しい資料を読ませたいのか、決めた形式で出力させたいのか、複数の操作を正しい順序で選ばせたいのか。改善したい対象を分けると、必要な仕組みを判断しやすくなります。
たとえば、社内文書を探して根拠付きで回答する用途なら、まず資料の取得と引用が正しくできるかを確かめます。そのうえで、手順の選び方や出力形式に繰り返し同じ失敗があるなら、追加学習が役立つかを比較できます。これは本記事の活用上の考察で、Inklingによる業務成果の報告ではありません。
LoRAで追加学習できる範囲にも限界があります。必要な知識や能力が不足している場合や、学習例と実際の仕事が大きく違う場合に、少量の調整ですべて解決できると考えるべきではありません。
LoRAの方式と調整上の注意点利用できることと、重みを持ち帰れることは違う。
2026年11月9日時点で、Inkling 2 SmallはTinkerで推論と追加学習を利用できます。一方、公式サイトでは重みは当初非公開で、安全性評価後に公開する方針とされています。発表時点の公開予定を、すでにダウンロード可能という意味で読むことはできません。
初代InklingとInkling-Smallの重みは公開済みです。これらと最新版では利用条件が異なります。「Inklingはオープンなモデル」というシリーズ全体の印象だけで、使いたい版の公開状況を判断しないことが大切です。
最新版と従来モデルの公開状況実際の上限と費用は、サービス側の仕様で確認する。
モデルの文脈長が最大100万トークンでも、現在のTinkerの掲載構成は64Kと256Kです。使いたいモデル名と構成に対して、実際の上限を確認する必要があります。
また、学習の費用と、その後に使う推論の費用は分かれます。入力の処理、回答の生成、学習、保存するチェックポイントなどを含めて考える必要があります。約426ドルという一つの実験の利用料を、どの用途にも必要な固定額として扱うことはできません。
公式のサーバーレス推論はベータと記載され、本番利用については問い合わせが案内されています。試せる環境があることと、必要な処理量や応答時間で運用できることも分けて確認します。
現在の提供構成・料金・ベータの案内長く働けるAIほど、完了の確かめ方が重要になる。
公式モデルカードは、もっともらしい誤情報、指示への不正確な対応、長い複数往復の会話での性能低下などを制約として挙げています。対応する言語や分野によって性能が均一とも限りません。
- 比較の基準:追加学習をしない場合の品質・時間・費用を残す。
- 未使用の問題:調整に使わないデータで、未知の入力への効果を見る。
- 実行の証拠:実行した版、操作、結果を残し、説明と実際の処理を照合する。
- 採用の判断:失敗や悪化も含めて比較し、必要なら元の版へ戻せるようにする。
そのため、仕事を任せる評価では、成果物が存在することと、目的を満たしたことを分けたいところです。実行した記録、テスト結果、参照したデータがそろって初めて、何ができたかを確認できます。日本語の業務では、日本語の資料と失敗例で調べることも必要です。
追加学習を評価する場合は、学習前の結果を残し、調整に使わない問題を分け、学習後に改善した部分と悪化した部分を比べます。モデルが自分で作った評価だけに依存せず、実際の目的に合う判定を別に用意することが重要です。ここで挙げる確認方法は、本記事の運用上の提案です。
モデルカードが説明する制約モデルを選ぶだけでなく、改善の工程を持つ。
Inkling 2 Smallから見えるのは、汎用AIの能力を利用することに加え、特定の仕事へ合わせるための作業をAIと学習基盤へ分担させる方向です。画面を見て修正することも、別のモデルを学習することも、行動の結果を次の判断へ戻す点でつながっています。
ただし、その工程の目的と評価基準は利用する側が持つ必要があります。何を正解とするかが曖昧なままでは、学習や試行を増やしても、仕事の価値が増えたかを判断できません。
今後の可能性を測る軸は、一度の印象的なデモだけでなく、同じ仕事で改善を繰り返せるか、使っていないデータでも効果があるか、費用や確認の手間を含めて続けられるかです。Inkling 2 Smallは、その工程を組むための選択肢として見ると、特徴と課題がつかみやすくなります。