BLOG
AIの高得点は、日本の仕事でも通用するのか。JFinBenchが測るもの
プログラミングが得意なAIでも、日本の税制や会計の問題に同じように強いとは限りません。Sakana AIのJFinBenchは、最新の金融資格試験から、その違いを測る評価です。検索や計算を使った結果と合わせると、モデルの知識と、仕事を任せるための検証の役割が見えてきます。

日本語を読めることと、日本の制度を知ることは違う
税額を求める問題では、掛け算が正しくても、適用する控除や時点が違えば答えを誤ります。会計の文章を自然な日本語で説明できることと、必要な条件を漏らさず当てはめることも違います。
Sakana AIが2026年11月17日に紹介したJFinBenchは、公認会計士・税理士など六つの金融資格試験の2026年実施回から作られた評価です。論文は11月13日に公開されており、会社の紹介日とは区別できます。一般的なAIの順位を、そのまま日本の金融業務での順位として使えるのかが出発点です。
Sakana AIによる概要321問の得点は、六つの試験を同じ重さで平均する
問題は選択式だけでなく、短い記入、複数の空欄、論述、図の読み取りも含みます。総合点は、六つの試験それぞれのスコアを同じ重みで平均した値です。321問をすべて同じ配点で集計した単純な正答率ではありません。

この違いは、結果を読むときに効きます。業務で税に関する確認を任せたいなら、総合点だけでなく税理士試験の内訳を見ます。広い分野の平均が高くても、自分の業務に近い問題で弱い可能性があるからです。
論文:採点と集計の方法モデル名だけでなく、考える設定と費用も見る
ツールなし・最大の推論設定での報告値は、Claude Fable 5が95.8、GPT-6 Astraが93.6、Kimi K3.1 Proが83.4でした。各設定を三回実行した平均であり、モデルを使えば毎回この割合で実務に成功するという数字ではありません。
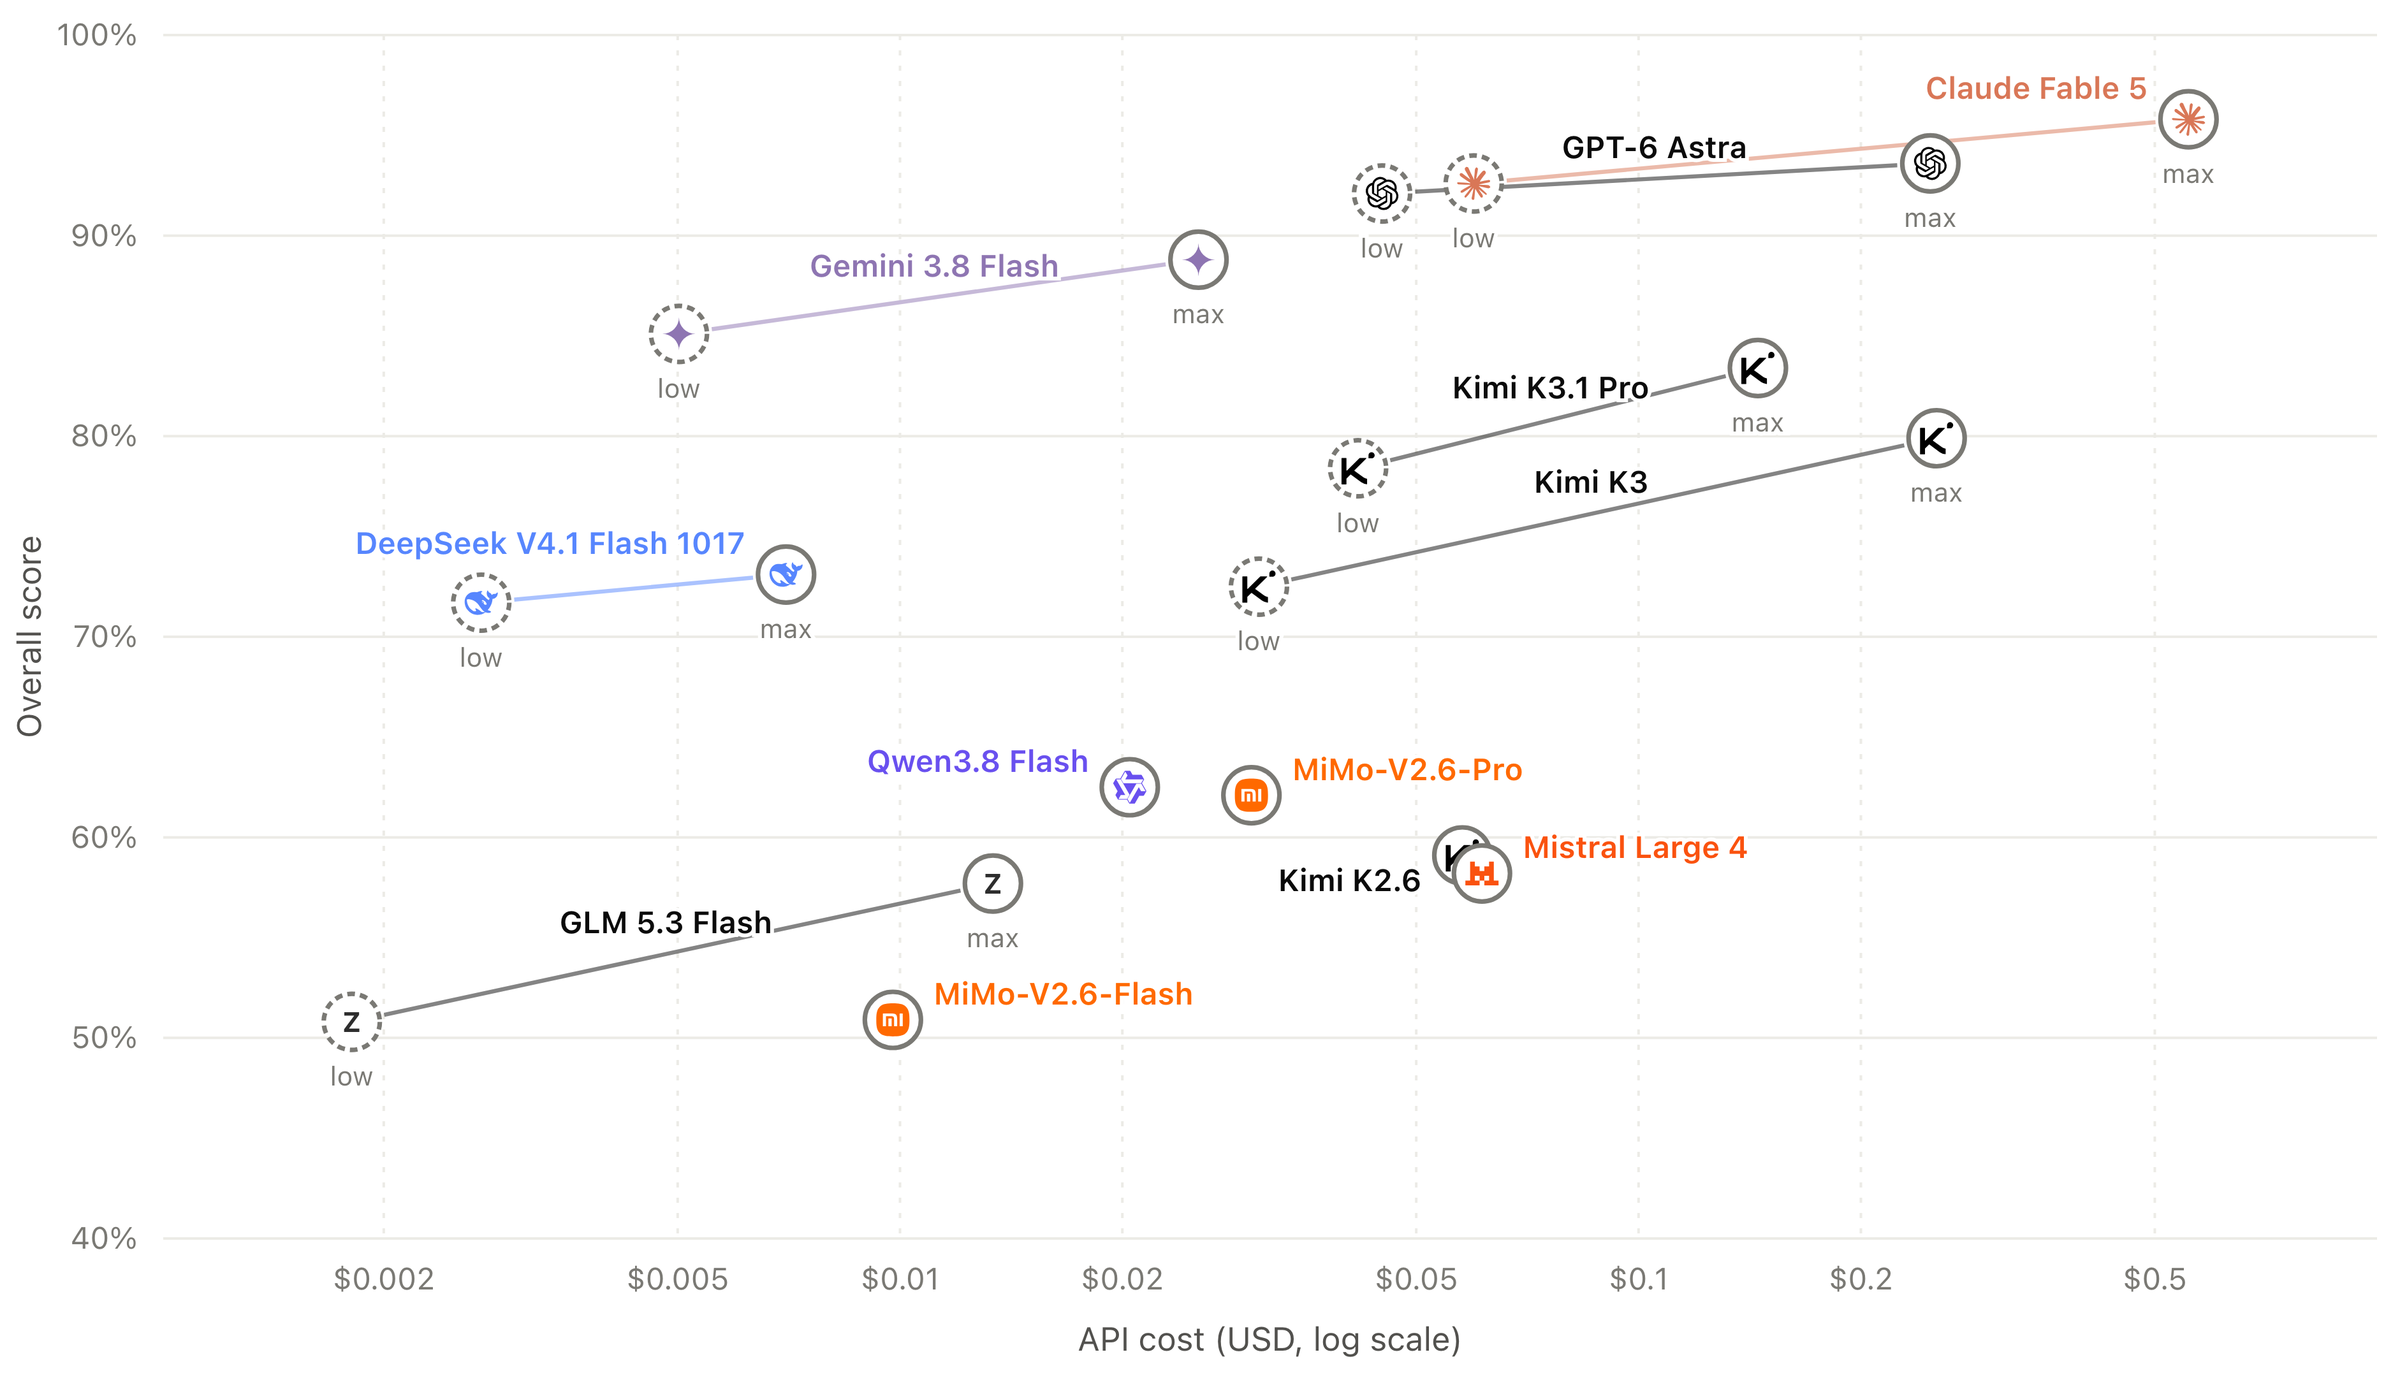
推論設定を変えると、答えを出すまでの出力量や費用も変わります。公開図の費用は測った入出力トークンと定価から計算され、採点側の費用を含みません。安いかどうかを判断するときは、人による確認や、誤答を直す時間も別に見積もる必要があります。
公開リーダーボードと評価条件検索や計算を使うと伸びるが、モデル以外の差も入る
追加実験では、端末での計算やWeb検索などを使える構成も評価されています。どのモデルも改善しましたが、得点はモデルと、道具の使い方を決めるエージェントの実行環境を合わせた結果です。論文は複数の実行環境からモデルごとの最良結果を採用しています。
したがって、ツールなしとの差を、そのまま「検索を一つ付けた効果」とは読めません。実務で比べる場合も、使える資料、検索の範囲、計算の道具、時間制限をそろえます。情報を探せることに加え、どの制度を探すべきか、見つけた条文をどう当てはめるかが問われます。
論文:ツールを使う評価の条件評価する問題も、AIに作業させた後で人が照合する
この研究のもう一つの特徴は、試験PDFから評価用データを作る手順です。画像を読めるモデルでページを転記し、コーディングエージェントが試験ごとの変換コードを作り、人がすべての問題を原本と照合します。
問題番号がずれる、表の列を取り違える、必要な図が欠ける。こうした変換ミスを残すと、間違った入力でAIの能力を測ることになります。公開コードと変換・確認の流れがあることで、新しい試験回に更新する作業も検証しやすくなります。モデルの評価には、評価する側のデータ品質も含まれます。
公開された評価・データ構築コード高得点でも、実務の判断や資格の代わりにはならない
採点の一部には、文章を扱う大規模言語モデル(LLM)が使われます。正解と同じ意味かを判定する利点がある一方、採点器の見落としは残り得ます。公開問題が学習に混ざる可能性も、申告された知識の期限より新しい試験を使うだけでは完全に除けません。
また、試験は必要な条件が問題文にまとまっています。実際の相談では資料が足りない、事情が変わる、何を質問すべきか自体が不明な場合があります。論文も、スコアが専門資格や専門家の代替を意味しないと明記しています。ここで測れた能力と、実務で追加して確かめる能力を分けることが必要です。
論文:評価の範囲と限界自社で使うなら、失敗の種類を分けて測る
JFinBenchから得られる実務への示唆は、特定のモデルを一律に選ぶことより、自分たちの仕事に近い問題で比べることです。制度の知識不足、資料の読み違い、計算ミス、書式の不備では、必要な対策が違います。
社内評価では、基準日、参照を許す資料、正解の根拠、人へ戻す条件を先に決めます。そのうえで、正答だけでなく、情報不足を認められたか、古い制度を持ち出していないか、誤りを確認者が見抜ける形で根拠を出したかも記録すると、任せる範囲を具体的に判断できます。