BLOG
AIは、なぜ「寝る」のか。Googleが研究する、忘れにくい学習
AIが会話を覚えているように見えることと、モデル自身が学ぶことには違いがあります。Google ResearchのSleep研究をもとに、短い記憶を定着させる仕組みと、学び続けるAIで重要になる情報の選び方を考えます。

AIの「睡眠」は、記憶を整理する学習時間。
AIに資料を渡すと、その内容に沿って答えてくれます。前に話したことを、次の会話で覚えているように見えるサービスもあります。ただ、その経験がモデル自身の知識になるとは限りません。情報をその場で読めることと、あとから資料を見せなくても使えることの間には、隔たりがあります。
Google Researchなどの研究者は、この隔たりに「睡眠」という発想で取り組んでいます。論文「Language Models Need Sleep」は、情報を受け取る段階と、それまでの記憶を定着させる段階を繰り返す学習方法を提案しています。眠る間も計算を続け、覚えた内容の整理や練習に時間を使います。
論文は2026年6月2日に公開され、7月10日に改訂されました。Google Researchが10月27日に公開した解説は、この研究を紹介したものです。ここで扱うのは学習方法の研究であり、Geminiに新しく搭載された機能の発表ではありません。
Google ResearchのSleep解説を読む「覚えている」は、どこに情報が残るかで変わる。
まず、モデルの「重み」を押さえておきます。重みは、入力から答えを作る計算に使う数値です。学習ではこの数値を調整します。一方、学習済みのモデルに資料を読ませて答えを作らせるときは、通常、重みをそのまま使います。資料の内容を回答に反映できても、その操作だけでモデルを更新しているわけではありません。
01 / WHERE INFORMATION REMAINS
「覚える」を、情報が残る場所で分ける。
会話の中で参照する
今回の入力会話や文書を入力に含め、その内容を使って答える。入力を参照できること自体は、重みの更新を意味しない。
保存して、次回取り出す
外部の記録履歴や文書を保存し、必要なときに検索してモデルへ渡す。保存・検索する仕組みが、情報を次の会話へつなぐ。
学習でモデルを更新する
モデルの内部答えを作る数値を更新し、情報を使える状態にする。Sleep研究が取り組むのは、短い記憶をこの状態へ定着させること。
会話履歴やメモを別の場所に保存し、次の質問で取り出してモデルへ渡す方法もあります。文書検索と回答生成を組み合わせるRAGも、外部の情報を使う仕組みです。検索する操作だけで重みが変わるわけではなく、保存と取り出しによって、以前の情報を再び使えるようにします。
たとえるなら、資料を机に広げて答えること、資料棚から必要なページを探すこと、繰り返し学んで資料なしでも答えられるようになることは、別の働きです。Sleepが目指すのは、短く残る情報を、モデルの内部で使い続けられる知識へ変えることです。
短期の情報と長期の記憶を扱う論文を読む新しいことを教えると、前の得意なことが崩れる。
それなら、新しい情報でモデルを学習させ続ければよさそうです。ところが、ある仕事に合わせて重みを更新すると、以前できていた別の仕事ができなくなる場合があります。新しいことを覚える過程で、前の能力に必要だった数値まで変わってしまうためです。この大きな性能低下を「破滅的忘却」と呼びます。
大切なのは、新しい情報に反応しやすいことと、役に立つ知識を安定して残すことを両立させることです。Googleの先行研究「Nested Learning」では、更新の頻度が違う複数の記憶の仕組みを扱っています。Sleepはこの考え方を背景に、変化しやすい側の記憶を、よりゆっくり更新する側へ定着させます。
記憶の更新頻度を分けるNested Learningの解説を読む「睡眠」の前半は、短い記憶を定着させる。
Sleepの一つ目の段階は「Memory Consolidation」、記憶の定着です。新しい情報を受け取っていた部分から、長く知識を持つ部分へ、学習によって内容を移します。会話の全文をそのまま保管するのではなく、答え方や知識を数値として引き継ぐ方法です。
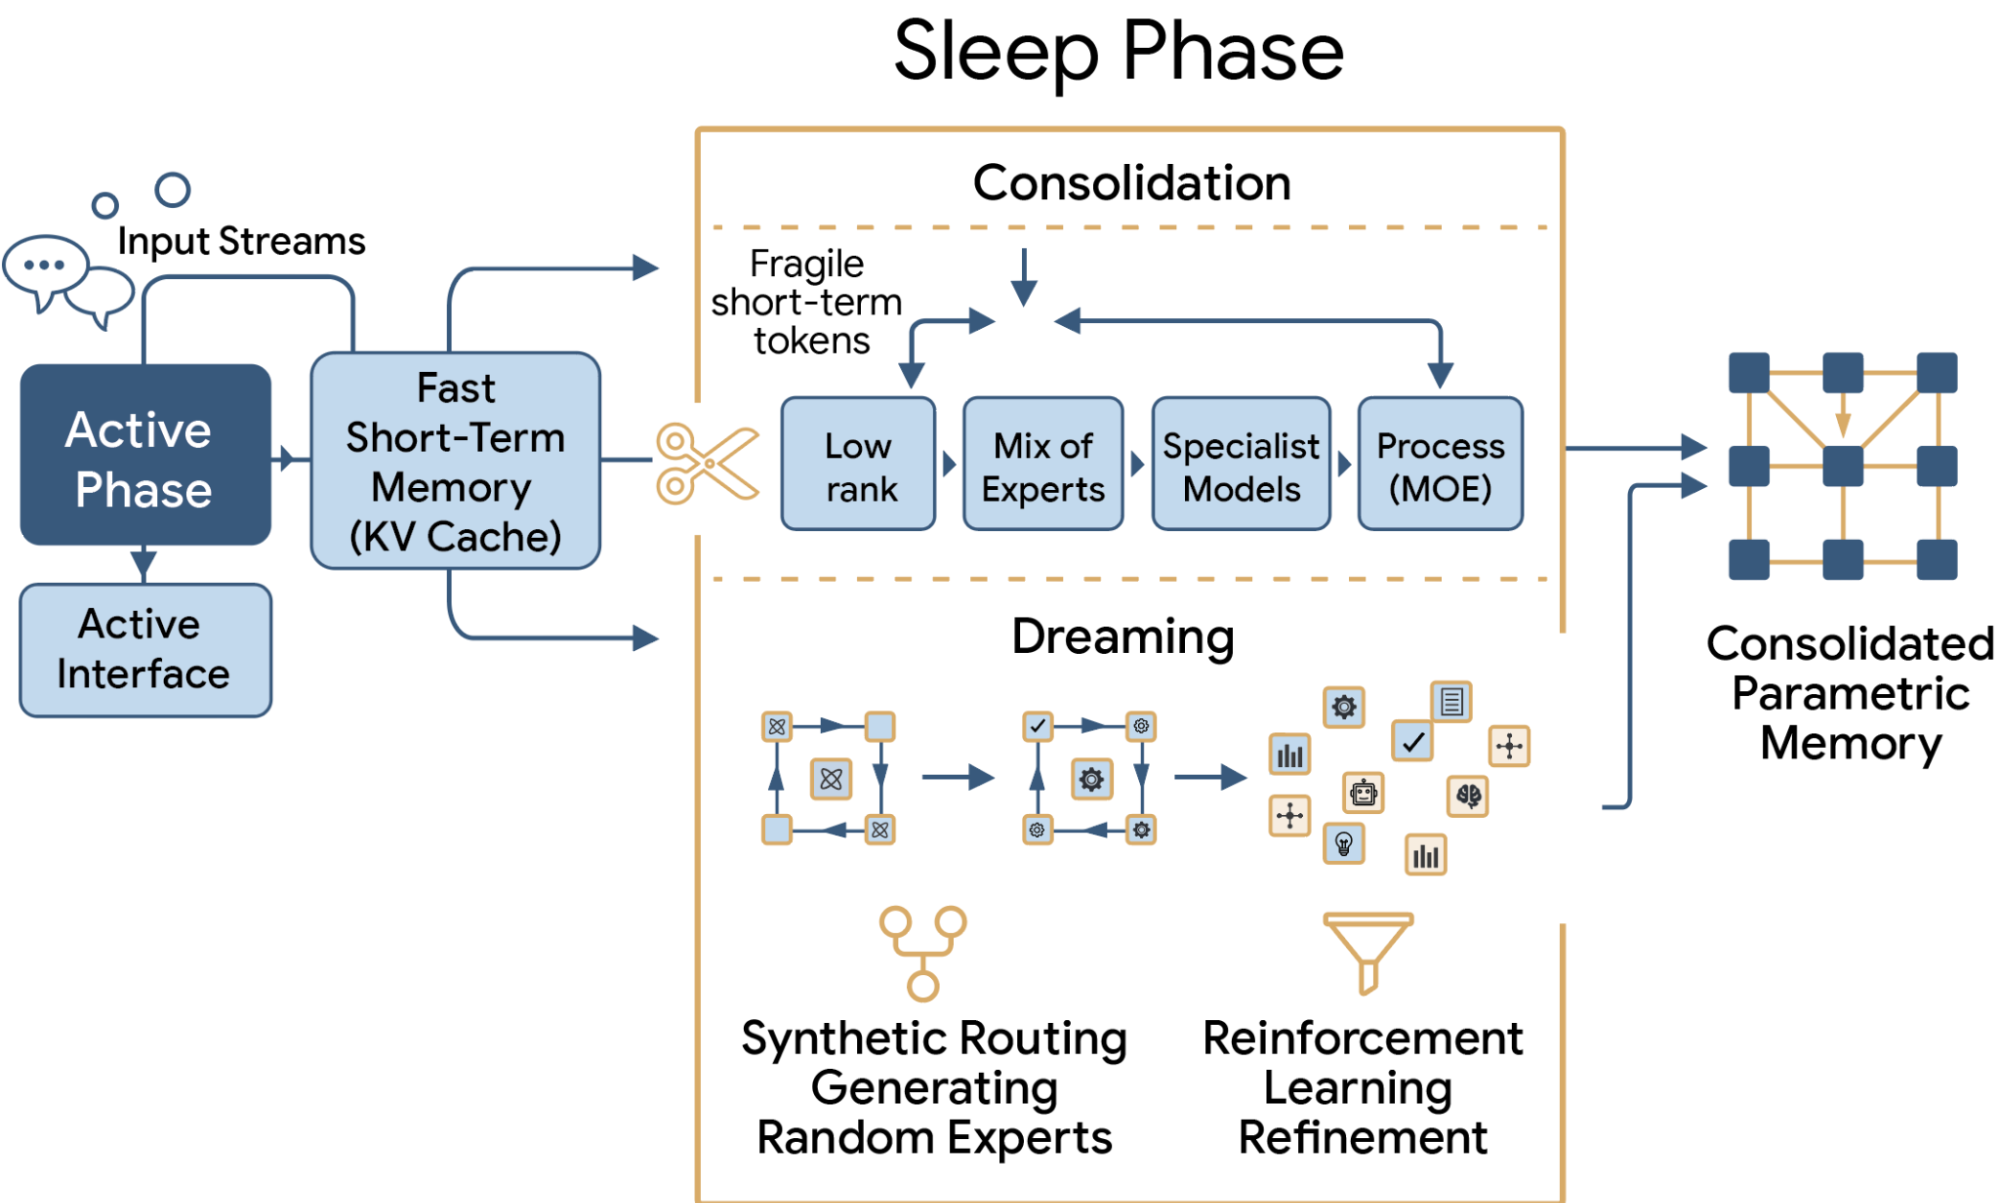
左が情報を受け取る段階、中央上が記憶の定着、中央下が「Dreaming」です。右の記憶は会話ログの保存先ではなく、学習で更新するモデルのパラメーターを表します。
出典:Google Researchの公式解説。© Google。
ここでは、既存の数値へ何でも上書きする代わりに、新しい知識を受け持つ小さな学習領域を有効にします。その領域へ、更新前のモデルが使えていた知識や振る舞いを引き継がせます。この転移を研究では「Knowledge Seeding」と呼んでいます。
一般的な「蒸留」では、大きなモデルの能力を小さなモデルへ移すことがあります。今回は、記憶を受け取る側に容量を用意する方向です。移し終えてから一時的な領域をリセットし、次の情報を受け取れるようにします。先に記憶を消してしまわない順序が重要です。
公式解説では、あらかじめ用意した領域を有効にする実装を説明しています。人が定めた構造と学習ルールの中で数値を更新する仕組みであり、AIがプログラムそのものを自由に書き換えるという意味ではありません。
記憶の定着と実装方法を原論文で読む「夢」は、自分で作った練習問題。
二つ目の段階が「Dreaming」です。モデルは、それまでの情報から学習用の文章や例を作ります。さらに、モデル内部の異なる処理部分を組み合わせて生成し、普段の入力だけでは得にくい練習の材料を探します。
生成したものを全部使うわけではありません。学習に役立ちそうな例を選び、その例で学習したモデルの成績が改善したかを評価します。改善につながる例の作り方を強めることで、練習の内容も調整していきます。
たとえば、新しい説明を読んだあとに、自分で確認問題を作り、解いて理解を確かめるような関係です。ただし、作った例が正しいか、以前の能力を損なっていないかを調べる仕組みが必要です。「自分の文章を読み続ければ、必ず賢くなる」とは言えません。
合成データの選択と評価を原論文で読む実験では、資料を見せ直さずに答えられるかを調べた。
論文の新しい事実を取り込む評価では、読解の評価データSQuADを使っています。200件の文章を学習したあと、対応する974問に、文章をその場で見せずに答えさせます。学習用の材料を自ら作る比較手法SEALも含め、報告された平均正答率は次のとおりです。
- 追加学習前のモデル:31.9%。
- 比較手法SEAL:43.2%。
- 4段階の記憶を使うSleep:46.2%。
この結果は、情報を入力に置いておくだけでなく、学習したあとに使える状態へ変える可能性を示しています。一方、最も高い46.2%でも、すべての問いに正しく答えられたわけではありません。数字はこの評価条件での研究者の報告です。
別の実験では、満州語とカラマン語の翻訳を順に学ぶ場面で、先に学んだ言語の能力をどれだけ保てるかも評価しています。新しい課題の点数だけでなく、前にできていたことを維持するという、この研究の狙いを確かめる実験です。
実験条件とTable 3の結果を読む学び続けるAIでは、何を覚えさせるかが重要になる。
ここからは、研究を実用へつなぐときの示唆です。社内の用語や作業の進め方を、使うたびに説明し直す負担を減らせるなら、AIは継続する仕事に合わせやすくなります。注目したいのは履歴の量だけでなく、経験を次の仕事で使える形にできるかです。
ただし、すべての情報を長く覚えればよいわけではありません。たとえば、文章の整え方や繰り返し使う手順は定着させたい一方、今日の価格や、すぐに変わる社内ルールは、その時点の正式な資料を確かめた方がよい場面があります。何を内部に学ばせ、何を外部の記録から参照するかは、情報の変わり方で分けて考えられます。
一時的な入力を、今後も使う知識へ変えるなら、その入力の扱いも変わります。誤った説明や個人情報まで定着させないよう、学習に使う範囲、保存の期間、訂正や削除への対応を設計する必要があります。これは論文が製品として解決した機能ではなく、継続学習を使う側に生じる課題です。
眠るためにも、計算と評価が必要になる。
Sleepは、待っているだけで知識が増える仕組みではありません。実用化を考えるときは、応答の速さに加えて、次の条件も評価する必要があります。
- 学習の費用:記憶を定着させ、練習例を作って評価する計算時間と、記憶を受け持つ領域が必要になる。
- 更新の品質:新しい仕事への改善と、以前できていた仕事への影響を、両方確かめる。
- 更新の時期:学習した状態をいつ反映し、問題があればどう戻すかを決める。
ローカルAIと組み合わせるなら、端末で答えを作れるかに加え、どこで追加学習を行い、更新した状態をいつ使い始めるかが新しい設計事項になります。この論文だけで、スマホが夜の充電中に自動学習する製品まで実証されたわけではありません。
実装と学習費用の補足を読むまとめ
AIの「睡眠」は、得た情報を整理し、次にも使える知識へ変える学習時間です。学び続けるAIでは、何を覚えたかに加え、何を残し、何を更新するかまでが重要になります。