BLOG
スマホの中で見る・聞く・判断する。LFM3が広げるローカルAI
Liquid AIのLFM3は、文章・画像・音声を扱う小型モデル群です。モバイルでAIを動かす意味を、速さや容量だけでなく、アプリの使い方、データの送信範囲、クラウドとの役割分担から考えます。

LFM3は、文章だけにとどまらない小型モデル群。
2026年10月27日、Liquid AIは新しいAIモデル群「LFM3」を公開しました。文章で対話するモデルに加え、画像や動画を見るモデル、音声を聞いて話すモデル、それらをまとめて扱うモデル、分類や項目の抽出などに向けた判断モデルがそろっています。
01 / CHOOSE THE INPUT AND TASK
入力と仕事に合わせて、モデルを選ぶ。
LFM3-1.7B
文章文章で対話し、決まった形式で答えたり、アプリの機能を呼ぶ指示を出したりする。
LFM3-VL-2B
画像・動画写真、書類、画面、動画の内容について、文章で質問・回答する。
LFM3-Audio-2B
音声音声を聞き取り、文字や音声で返す。話した内容から機能を呼ぶ指示も作る。
LFM3-Omni-2B
画像+音声+文章見ているものと話していることを合わせて扱い、文章や音声で返す。
d1-2B
文章・画像から判断分類、項目の抽出、位置の特定などを、アプリが受け取れる決まった形式で返す。
d1-Omni-2B
音声も含めて判断d1の判断処理へ音声入力を加える。自由な会話を続けるモデルとは役割が異なる。
「ローカルAI」とは、スマートフォンやPCなど、手元の機器でAIの計算を行う使い方です。LFM3は、用途に合わせた小型モデルを選び、アプリが動く場所で使うことを目指しています。一つのモデルに、すべての機能が入っているわけではありません。
ローカルでLLMを動かす取り組み自体は、以前からあります。今回注目したいのは、会話の文章だけでなく、カメラに映るものや話しかけた声を扱う選択肢が、近い規模のモデル群として広がったことです。これは、スマホの中にどんなAI機能を置けるか、という問いにつながります。
LFM3の公式発表を読むスマホで動くとは、何をどの条件で確かめたのか。
Liquid AIは、文章向けのLFM3-1.7Bについて、iPhone 17 Pro上のアプリで測定した結果を公開しています。使用したのはllama.cppという実行ソフトで、モデルを4ビットのQ4_0形式にした条件です。約3万2,000トークンを扱う設定、同時処理数1、生成100トークンで、入力を読む速さ・文章を作る速さ・メモリ使用量を測っています。
トークンは、AIが文章を処理するときの区切りです。日本語の一文字や一語と常に対応するわけではありません。また、この測定は開発元による特定の端末・ソフト・条件での結果であり、すべてのスマホや画像・音声の処理が同じ速さで動くことを示すものではありません。
小型化は、単に機能を減らすだけではありません。LFM3は、近くの語の並びから特徴を拾う処理、一定範囲の語同士の関係を見る処理、全体の文脈を参照する処理の三種類を組み合わせています。すべての層で同じ計算をする構成を避け、情報の扱い方を分担する設計です。端末での速度やメモリの制約を、モデルの構造から考えている点も特徴です。
発表では、文章モデルの重みは4ビットで約1GBとされています。重みは学習で得た数値の集まりで、4ビット化はその表現を小さくする方法です。ただし、入力や会話を保持する作業領域なども別に必要です。「約1GB」は、アプリ全体がそのメモリだけで動くという意味ではありません。
文章モデルが扱える最大の長さは、入力と出力を合わせて256K(約26万)トークンです。一方、LFM3-Omni-2Bは32K(約3万2,000)トークンです。長い会話や画像・音声をどれだけ扱えるかは、選ぶモデルと機器の余裕を分けて考える必要があります。
測定条件と文章モデルの仕様を読む見ることと聞くことを、同じ会話の中で扱う。
LFM3-Omni-2Bは、文章、画像、動画、音声を受け取り、文章や音声で返すモデルです。公式カードでは約22億の学習済みパラメーターを持つと説明されています。これはモデルの規模の目安で、文章モデルの約1GBという条件を、そのまま当てはめることはできません。
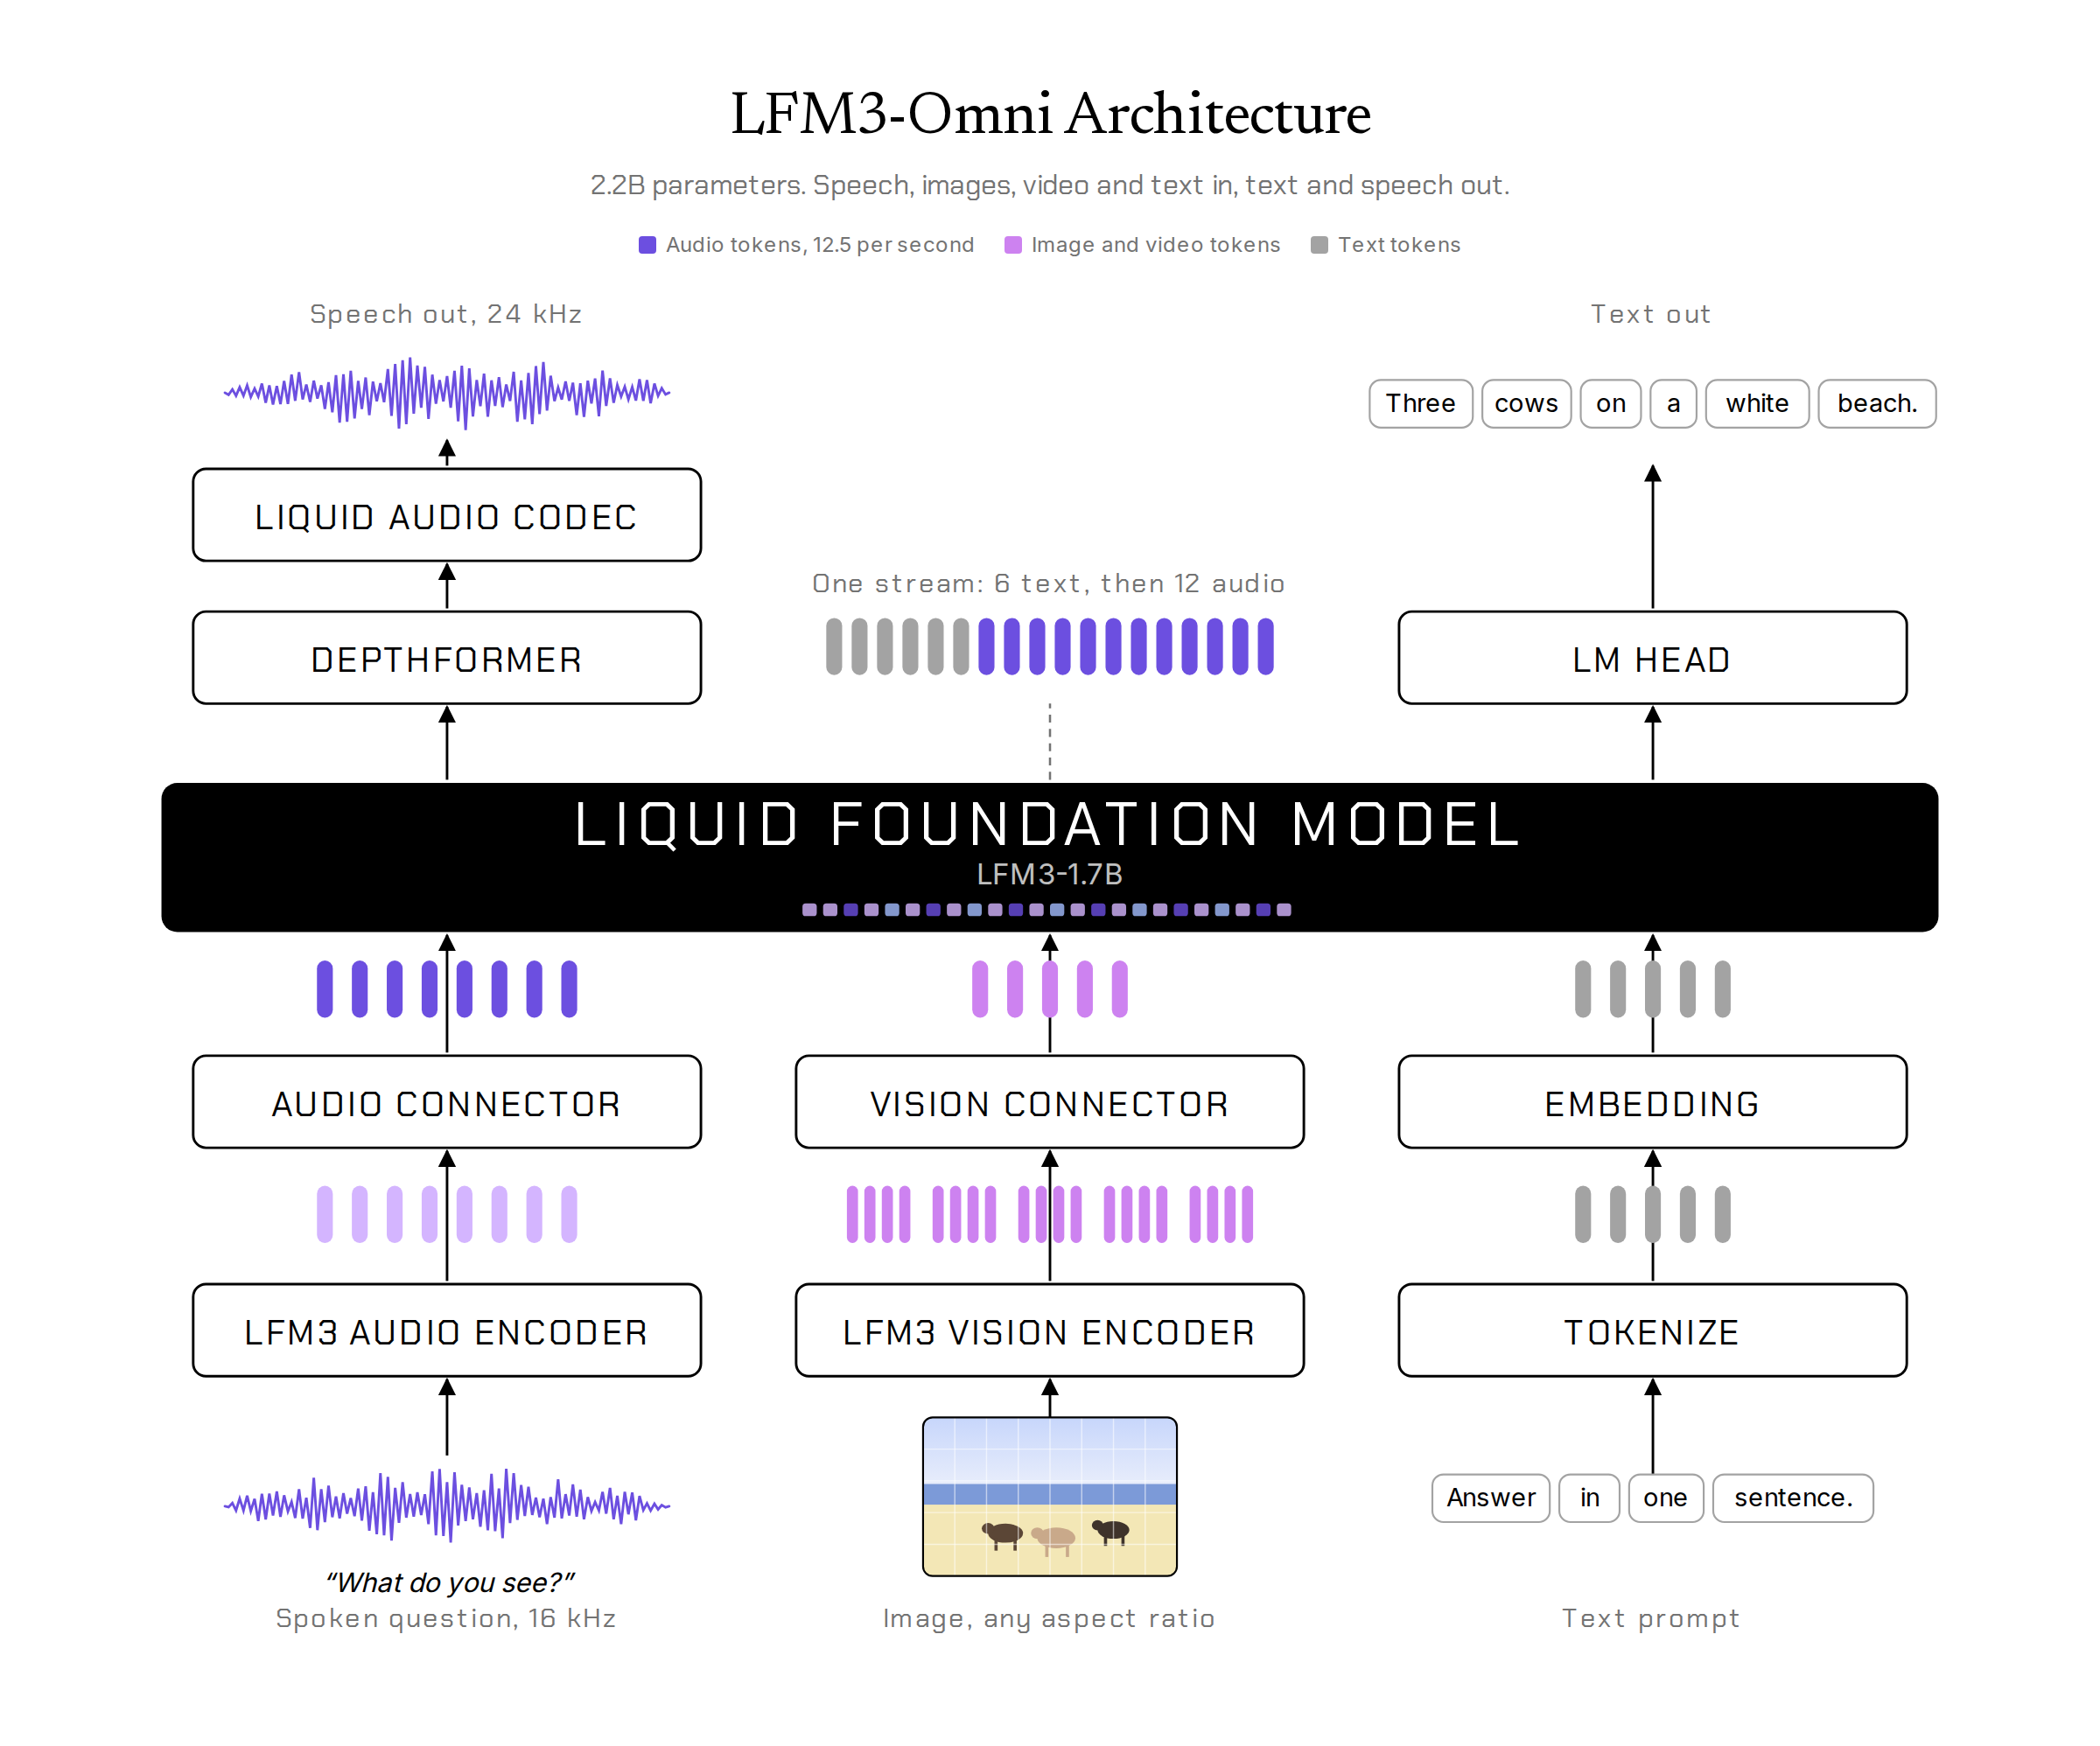
図は下から上へ読みます。音声・画像・文章を共通の基盤へ渡し、文章や音声へ変換して返す構成です。アプリの操作や外部サービスへの接続は、この図とは別に実装します。
出典:Liquid AI公式モデルカード。© Liquid AI。
たとえば、目の前の書類をカメラで映しながら「この日付は何日?」と話しかける場面を考えます。画像だけなら、どの情報を知りたいのかを別に入力する必要があります。音声だけなら、「この」が何を指すのかを伝えにくい場合があります。両方を合わせて扱えると、目の前の情報と質問を一つのやり取りにできます。
これは応用の想定であり、どんな書類も正確に読めるという保証ではありません。それでも、文字入力のために手を止めにくい作業や、見ている対象を言葉だけで説明しにくい場面で、操作の負担を減らす可能性があります。
画像・音声を統合するOmniモデルの仕様を読む会話の答えを、アプリが使える結果に変える。
アプリが必要とするのは、長い返答とは限りません。写真から品番を取り出す、入力内容を分類する、画面上の対象を見つける、といった結果の方が使いやすい場面があります。LFM3のd1モデルは、こうした判断や抽出を、決まった形式の答えとして返すことに向けられています。
たとえば、次のような機能が考えられます。いずれも製品化済みの機能として挙げるものではなく、入力と出力の能力から考えた設計例です。
- 作業メモ:写真の品番や日付を取り出し、話した注意点と合わせて、確認できる記録の候補にする。
- 学習の補助:手書きのノートと音声の質問を合わせて扱い、どこを知りたいかの入力を短くする。
- 入力の補助:書類や画面から項目を拾い、フォームへ入れる候補を示す。確定や送信はアプリの手順で行う。
ただし、モデルが操作の指示を出すことと、実際に保存・送信・変更を行うことは別です。公式のツール呼び出し手順でも、指示を受け取ったアプリ側が機能を実行します。何を操作でき、どの結果を人が確かめるかは、アプリの設計に残ります。
d1モデルの判断・抽出の仕組みを読む毎回、外へ送らなくてよい処理が増える。
写真や音声を端末内で処理できれば、推論のたびにその内容をサーバーへ送る必要を減らせます。通信の往復を待ちにくい場面でも、手元の情報を整理する処理を続けられる余地ができます。
02 / LOCAL PROCESSING AND CONNECTIONS
手元で整理し、必要な処理を外へつなぐ。
端末内で行う処理
必要な項目や操作の候補↓アプリが結果を確認
操作の権限を判断
この範囲を端末内で完結させれば、
推論のたびの送信を減らせる。
外部との接続が必要な処理
別のモデルでの処理・サービス連携↓結果をアプリへ戻す
ネットワークや外部APIを使う部分は、
接続先ごとに別の権限を持つ。
たとえば作業記録なら、写真を端末内で読み、必要な項目を利用者が確認してから、記録先へ同期する構成が考えられます。何を外へ送るかを決める前に、手元で情報を整理できる点に意味があります。
一方、ローカルで推論するアプリも、Web検索やクラウドへの保存、外部サービスの操作には通信を使います。モデルのダウンロードや更新もあります。モデルの計算場所だけでプライバシーが決まるわけではなく、入力、記録、解析用の通信、外部機能を含めたアプリ全体の流れを見る必要があります。
モデルの出力から機能を実行する流れを読むクラウドとの役割分担を、仕事ごとに選べる。
端末内のAIが広がると、すべての処理を同じ場所へ集める前提を見直せます。短い入力の整理や、その場で必要な応答は手元で行い、より大きなモデルが必要な処理や外部の最新情報を使う処理だけ、別の基盤へつなぐ設計です。これはLFM3に組み込み済みの自動切り替え機能ではなく、アプリ側で選べる役割分担です。
小さいモデルに任せる範囲にも見極めが要ります。LFM3-1.7Bの公式カードは、知識を多く要する作業では検索の利用を勧め、複雑な多段階の推論や自律的な開発作業には推奨しないとしています。ベンチマークの一部で高い点が出ることと、自分の仕事を最後まで安定して終えられることは同じではありません。
重要なのは、小型モデルを一律に大きなモデルの代役にすることより、得意な範囲をアプリの機能として区切れることです。必要な入出力を選び、その仕事に合わせて調整する発想は、ローカルLLMの使い道をチャット以外へ広げます。
文章モデルが示す用途と限界を読むこれからの評価は、アプリ全体で行う。
スマホに入る容量かどうかは、導入の入口です。実用性を判断するには、その端末で利用者の入力から必要な結果まで届くかを確かめます。発熱や電池、ほかのアプリと同時に使うメモリも、使い続けるための条件になります。
- 入力からの待ち時間:文章の生成速度だけでなく、写真や音声を読み始めてから結果が使えるまでを測る。
- 実際の仕事での品質:日本語、現場の言い回し、暗い写真や周囲の音など、使う条件で誤りや確認の必要性を調べる。
- 継続して使える条件:連続動作時のメモリ・電池・発熱と、外部通信や操作の権限を合わせて確かめる。
また、公開されている重みをダウンロードできることと、あらゆる条件で自由に製品へ組み込めることは別です。LFM3には独自ライセンスの商用利用・配布条件があります。実行ソフトの対応もモデルの種類ごとに異なるため、使いたい入出力、動かす機器、配布する製品を組み合わせて確認する必要があります。
ここから考えられる変化は、ローカルLLMを「どこまで賢い返答ができるか」だけで比べにくくなることです。利用者の見ているものや声を扱い、待たせずに適切な機能へつなぎ、必要な情報だけ外とやり取りできるか。そのまとまりが、アプリの価値を左右するようになります。
公開モデルの利用条件を読むまとめ
LFM3は、見る・聞く・判断する処理を、手元のアプリへ組み込む選択肢を広げます。ローカルAIの価値は、モデルの小ささに加え、利用者の情報と操作をどこまでその場でつなげられるかで決まっていきます。