BLOG
AIの中にCPUを入れる。Qwenputerは計算をどう変えるのか
Qwenputerは、言語モデルの内部へ仮想CPUを組み込む実験です。文章を理解する役割と、命令どおりに計算する役割をどう組み合わせるのか。仕組みと評価結果から、正しさを確かめる場所と実用化の課題を考えます。

コンピューター上で動くAIの中に、もう一つのCPU。
AIもコンピューター上で動いているのに、その中にCPUを入れるとはどういうことでしょうか。Qwenputerは、言葉を扱うAIの計算に、機械の命令を実行する仕組みを組み込んだ実験です。物理的なチップを増設するのではなく、CPUの働きをモデルの処理層として表します。
開発者のDivyansh Agrawal氏は、Alibabaの言語モデルQwen3.5-4Bを基に、32ビットのRISC-V CPUを組み込みました。RISC-Vは、足し算や比較、条件による分岐など、CPUが実行する命令を定めた仕様です。Qwenputerは、その命令をモデルの推論処理の中で進めます。
注目したいのは、AIの計算が一律に賢くなったという話より、文章を理解する部分と、決められた手順を実行する部分をどう組み合わせるかです。Qwenputerは、独立した開発者による実験モデルとして公開されています。
開発者によるQwenputerの解説を読む文章を作ることと、式を正しく実行すること。
通常の言語モデルも、内部では大量の数値計算をしています。ただし、その計算は文脈に沿った文章を生成するためのもので、質問に含まれる算数の式を必ず正しく実行することとは別です。長い数の掛け算で、もっともらしい桁の数値を返しても、正解とは限りません。
01 / WHO EXECUTES THE CALCULATION
文章を作る役割と、計算する役割。
通常の文章生成
言語モデル質問 → 文脈に沿って回答を生成。計算問題でも、文章として出す数値が正しいかを確かめる必要がある。
外部ツールを使う構成
モデルの外質問 → 式を作る → 外部のPythonなどで実行 → 結果から回答を作る。計算を別の実行環境へ任せる。
Qwenputer
モデルの内部質問 → 式を作る → 追加したCPUの処理層で実行 → 結果から回答を作る。式を選ぶ部分と、実行する部分を内部で組み合わせる。
この問題には、電卓やPythonへ式を渡して実行し、その結果を使って答える方法があります。すでに使われている外部ツールの構成です。Qwenputerが変えるのは、その計算を担当する場所です。
Qwen側が作った式を、外部のPythonで評価する代わりに、追加したCPUの処理層へ渡します。言葉で問題を解釈する役割と、機械の命令どおりに計算を進める役割を、同じモデルの中で分けて持たせます。
内部CPUと外部ツールの比較を読むCPUの規則は、学習させずに重みへ組み込む。
モデルの重みは、処理のしかたを決める数値です。一般的なAIでは学習によって調整しますが、Qwenputerで追加するCPU部分は、コンパイラーが数値を直接決めています。足し算や分岐などのCPUの動作規則を、モデルが行う演算の組み合わせへ変換する方法です。
公開構成では、元のQwenの32層より前に、CPU用の11層を加えています。Qwenが学習した元の重みは保ち、新しい処理層と領域を追加します。CPUの働きを学習で発見させたというより、人が定めた規則を、ネットワークの中で動かせる形にしたものです。
ここが、この実験のおもしろい点です。モデルの能力を増やす手段として、学習データやパラメーター数を増やす以外に、厳密に動く処理を設計して組み込む選択肢を示しています。
追加層と元の重みの構成を読む途中の数値を、指定した場所へ正確に残す。
CPUが計算を続けるには、途中の数値や、次にどの命令を実行するかを置く場所が必要です。Qwenputerは、Qwen3.5が持つGated DeltaNetという仕組みの内部状態を、この作業用メモリとして使います。
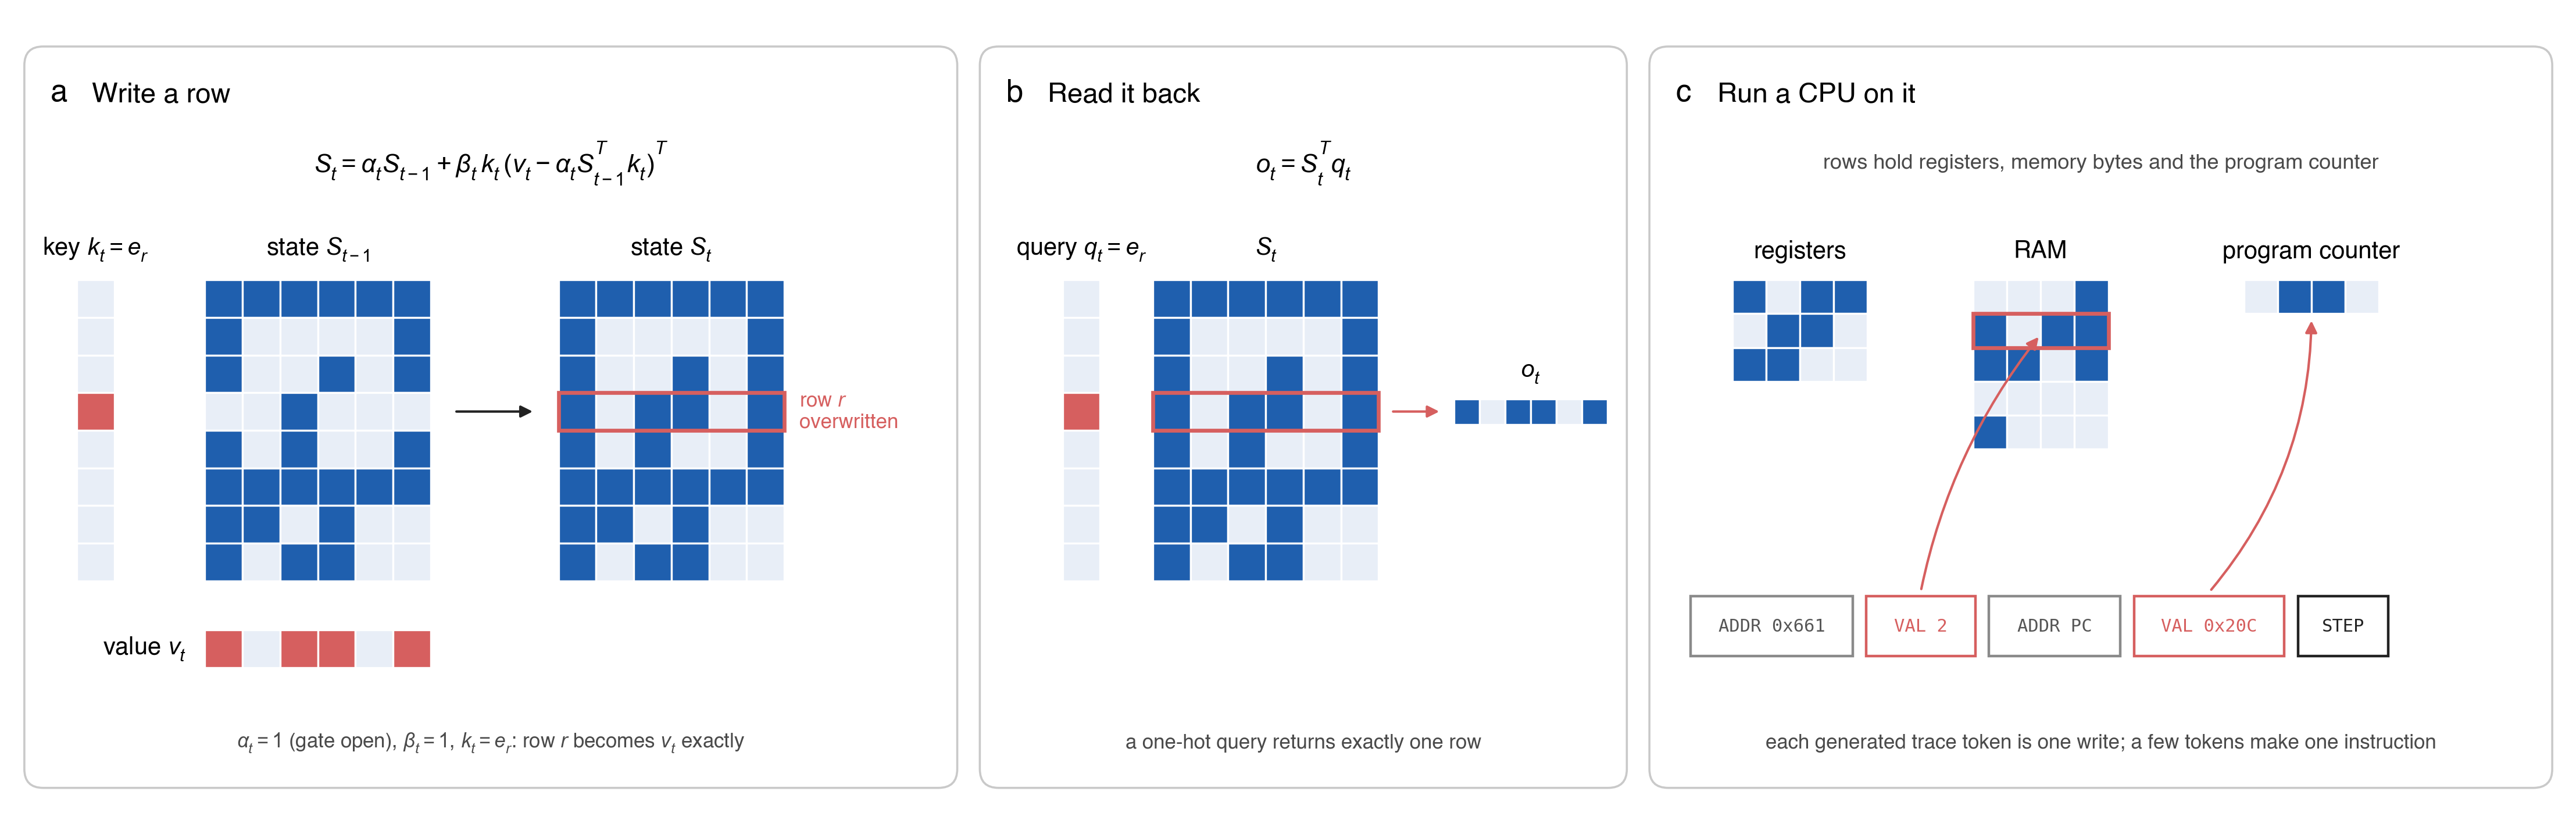
左は書き込み、中央は読み出し、右はCPUでの利用です。途中の数値や、次に実行する命令の位置を保つことで、計算を一段ずつ進められます。
出典:Qwenputerモデルカード。© Divyansh Agrawal。
イメージするなら、番号付きの引き出しです。書き込む場所を一つ指定し、その場所を新しい値で置き換える。同じ場所を指定すれば、値を取り出せる。作者は、情報が薄れる設定を止め、指定した場所だけを読み書きするよう制御して、これを実現しています。
ここで実行中に変わるのは、モデルが保持する作業用の状態です。CPUの規則を表す重みと、そのCPUが扱う数値を置く場所は、分けて考える必要があります。会話のたびに、計算内容を重みへ追加学習しているわけではありません。
作者はさらに、内部状態へテキストをファイル名付きで保存・取得する別の実験版も公開しています。次の会話へ引き継ぐには、この状態を保存して読み込む処理が必要です。これは実験用の別モデルで、通常のQwenputerにすべてが含まれるわけではありません。
内部状態をRAMとして使う仕組みを読む内部で動かすための、専用の制御もある。
Qwenは、学習済みのツール呼び出しの書式を使って計算式を渡します。ただし、計算結果を返すのは外部の計算サーバーではなく、組み込んだCPU側です。計算の進行を表す専用トークンを処理し、結果をQwen側が読める文章へ戻します。
その間を扱うのが、RvChatという専用のドライバーです。CPUを起動するためのプログラムを内部状態へ読み込み、計算用トークンと通常の会話を分けて処理します。公開コードにも、この初期化と切り替えの経路があります。
「モデル内部で計算する」は、推論を動かすソフトウェアやGPUが不要になるという意味ではありません。計算の規則をネットワークの演算として実装し、それを動かす制御も合わせて用意する構成です。通常の生成処理を呼ぶだけで、そのまま動く仕組みにはなっていません。
公開コードの初期化と生成処理を読む計算は改善した。ただし、回答全体の正しさとは分けて見る。
現在のRISC-V版のモデルカードには、同じ問題を通常のQwen、Qwenputer、外部Pythonツール付きのQwenで比較した結果があります。各セット40問で、出力の候補から、確率が最も高いものを順に選ぶ生成条件です。大きな整数の掛け算を扱うDeepMindの評価では、作者は次の結果を報告しています。
- 通常のQwen3.5-4B:55.0%(22問正解)。
- Qwenputer:97.5%(39問正解)。
- 外部Pythonツール付きのQwen:100%(40問正解)。
Qwenputerは通常のQwenから改善していますが、この例では外部Pythonツールを上回っていません。また、40問での結果を、あらゆる計算問題へ一般化することもできません。
さらに、CPUが返す値が正しくても、AIが最終回答を間違える余地は残ります。開発時の記録には、正しい計算結果を得たあとで別の数値を答えたり、確認を繰り返して回答を終えられなかったりした例があります。どの式を作り、得た結果をどう伝えるかは、引き続き別の評価対象です。
評価と、正しい計算から誤答した例を読む重要なのは、何を学習に任せるか。
この実験から考えられるのは、AIの能力を、すべて文章生成の上達として扱わなくてもよいということです。問題を読み、必要な操作を選ぶ部分には学習したモデルを使い、計算や記録の読み書きには規則に沿う処理を組み合わせる。Qwenputerは、その分担をモデル内部で試しています。
たとえば、数量の集計や単位の換算では、計算式を決めたあとの処理を正確にしたい一方、そもそも数値や単位を読み違えていないかも確かめる必要があります。内部CPUは、後者まで自動的に解決するものではありません。これは活用を考えるための例であり、製品で検証済みの用途を示すものではありません。
外部ツールへ任せる構成も含めて、問題の解釈、手順の実行、最終回答をそれぞれ確かめる。その見方が大切になります。内部化の価値は、「AIが自分で計算した」という印象より、どの役割をどの仕組みで担い、全体として何を改善できるかで判断できます。
実用化には、容量と速度の評価が残る。
Qwenputerは実験段階で、作者は次の制約も説明しています。式の長さや扱える数値にも上限があり、モデル内へ機能を組み込めることと、広い用途で軽く速く動かせることは、別の検証が必要です。
- 配布される重みの容量:約18.8GB。追加した領域の多くはゼロ埋めでも、公開ファイル全体の容量は増えている。
- 実行環境:作者が案内する構成は24GB GPU一台。スマートフォンでの動作が確かめられたモデルとして扱うことはできない。
- 計算時間:CPUの命令を進めるために専用トークンを処理する。大きな計算は秒単位になると説明されており、通常の電卓の代わりに高速化する技術ではない。
現時点では、計算ツールをすぐ置き換える完成品としてより、学習した言語処理と設計した計算処理を組み合わせるための実験として見ると、意味がつかみやすくなります。比べるべきなのは、計算部分の正確さに加え、回答までの時間、必要な容量、組み込みの手間です。
作者が挙げる制約と実行条件を読むまとめ
Qwenputerは、学習したAIの内部へ、規則どおりに動くCPUを組み込む実験です。計算を正確にする部分と、何を計算してどう答えるかを決める部分を分けて評価することが、その価値を理解する鍵になります。